
- Коротко: если вы перебрали много вариантов и оставили лучший, его p-значение надо считать относительно лучшего из всех, а не самого по себе. Иначе «значимость» в основном измеряет, как усердно вы искали.
- В примере Халберта Уайта 3654 линейные модели дневной доходности S&P 500 дали лучшую модель, угадавшую направление рынка в 54,7% случаев против 50,8% у константы. Если считать её единственной, p = 0,0036. С учётом перебора — 0,2040.
- Поправка — бутстрэп, который спрашивает, как часто лучший из всех кандидатов обыграл бы бенчмарк на такую величину, если бы ни у одного не было реального навыка. Разницу между двумя p-значениями статья называет прямой оценкой смещения от перебора данных.
- Метод работает только с тем, что вы записали. В сравнение должны войти все варианты, включая отброшенные.
Коротко. Если вы перебрали много версий стратегии и показываете лучшую, честный вопрос звучит не «маловероятен ли этот результат случайно?», а «маловероятен ли он среди лучших из всех версий, которые я пробовал?». Халберт Уайт построил тест именно для этого. В его примере модель, у которой p-значение само по себе выглядело как 0,0036, получила 0,20 после того, как учли 3654 модели перебора, а это совсем не убедительно.
Что такое data snooping и почему его трудно избежать?
Уайт начинает с определения (перевод наш):
Data snooping возникает, когда один и тот же набор данных используется больше одного раза для вывода или выбора модели.
White, «A Reality Check for Data Snooping», Econometrica (2000)
Его довод: во временных рядах обычно есть одна история, поэтому повторное использование данных почти неизбежно.1 Прогоните достаточно спецификаций по одной истории цен, и некоторые будут выглядеть хорошо без какой-либо реальной прогнозной связи. Он сравнивает это с «рассылкой-аферой»: разослать бесплатные рекомендации многим, половине сказать, что рынок вырастет, половине, что упадёт, дальше писать только тем, кому «повезло», и через несколько раундов у части адресатов окажется безупречный послужной список по построению.
Перебор параметров в трейдинге устроен так же. Длины скользящих, расстояния стопов, фильтры по сессиям и пороги входа перемножаются в сотни вариантов, и победитель этого конкурса выбран за то, что ему повезло на этой выборке. Первую, простую версию мы разбирали в статье почему бэктесты вводят в заблуждение.
Что именно показал пример Уайта?
Он применил свой тест к намеренно обычной задаче: прогнозу дневной доходности S&P 500 на один день вперёд. Он построил 29 технических индикаторов того вида, которым пользуются товарные трейдеры (импульс, локальные тренды, индексы относительной силы, осцилляторы скользящих средних), и оценил все линейные модели с константой и ровно тремя индикаторами. Это 3654 модели. Бенчмарк — одна константа, то есть идея, что доходность не прогнозируется. Окно оценки — с 3 июня 1991 по 31 мая 1994, 758 торговых дней.2
Лучшая по точности направления модель угадывала знак следующего дня в 54,75% случаев против 50,79% у бенчмарка. Разрыв около четырёх процентных пунктов, а два p-значения рассказывают очень разное:
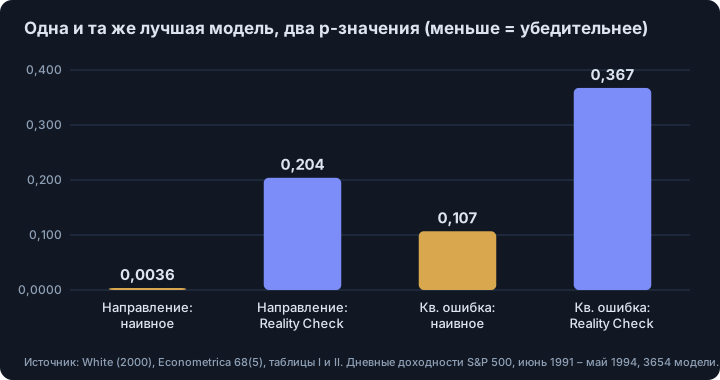
| Критерий | Лучшая модель | Бенчмарк | Наивное p | p по Reality Check |
|---|---|---|---|---|
| Точность направления | 54,75% верных | 50,79% | 0,0036 | 0,2040 |
| Среднеквадратичная ошибка прогноза | RMSE 0,006373 | RMSE 0,006410 | 0,1068 | 0,3674 |
Комментарий Уайта к первой строке резок: «This example dramatically illustrates the dangers of data mining» («этот пример наглядно показывает опасность перебора данных»).2 p-значение 0,0036 прошло бы почти любую планку трейдера. После поправки на перебор оно обычные 0,20. В статье также сказано, что разница между двумя числами даёт прямую оценку смещения от перебора данных.
Как работает Reality Check?
Нулевая гипотеза: лучшая модель, найденная при переборе, не превосходит бенчмарк по прогнозной силе. Тест не спрашивает, насколько хороша лучшая модель. Он спрашивает, насколько хорошей выглядела бы лучшая из 3654 моделей, если бы ни у одной не было навыка, и сравнивает с ней ваш реальный лучший результат.
Для трейдера упрощённая версия идеи выглядит так (наше описание принципа, а не полной процедуры Уайта):
- Храните ряд доходностей каждого опробованного варианта на одних и тех же датах, а не только победителя.
- Перевыберите временную ось (блоками, чтобы сохранить автокорреляцию) и примените те же перевыбранные даты ко всем вариантам.
- В каждой перевыборке запишите лучший средний результат среди всех вариантов, предварительно отцентрировав каждый вариант так, чтобы гипотеза «навыка нет» выполнялась.
- p-значение — доля перевыборок, где лучший результат не хуже наблюдённого вами.
В этом примере Уайт использовал стационарный бутстрэп с 500 перевыборками.2 Поскольку весь набор перевыбирается вместе, метод учитывает, что варианты одной идеи сильно коррелированы. Это важно для следующего пункта.
Всегда ли больше перебора означает меньше доказательств?
Нет, и Уайт это говорит сам. Сильно коррелированные прогнозы добавляют мало новых «шансов»: на его графиках p-значение остаётся ровным на целых участках, пока добавляются похожие модели, а рассмотрение даже большого числа моделей не обязано приводить к резкому падению p-значения Reality Check (перевод наш).2 Он также рассуждает (эвристически, без строгого доказательства), что настоящая связь не обязана «похорониться» при корректно контролируемом переборе, потому что мощность теста растёт с размером выборки. Иначе говоря, поправка — не приговор поиску. Это прейскурант.
Отсюда два практических вывода. Узкий поиск вокруг одной идеи (десять соседних значений параметра) стоит намного дешевле, чем десять не связанных идей. А если наивное p-значение и так большое, поправлять нечего: скорректированное может быть только больше.
Что с этим делать трейдеру?
- Записывайте каждый вариант. Тест честен ровно настолько, насколько честен набор, который вы ему дали. Отброшенные варианты считаются, как и те, что вы перестали гонять после плохой недели.
- Сравнивайте с бенчмарком, который вы использовали бы иначе: держать актив или сидеть вне рынка, а не с нулём.
- Указывайте число вариантов рядом с любым результатом и читайте результаты перебора как эффект отбора.
- Храните нетронутые данные. Один заранее объявленный тест на данных, не участвовавших в выборе правил, не требует поправки на перебор. О размере выборки читайте в статье сколько сделок доказывают, что стратегия работает, а о том, что тестовая вселенная молча отбрасывает, — в ошибке выжившего.
Это образовательный материал, не инвестиционная рекомендация. Пример Уайта — фондовый индекс начала 1990-х и линейные модели; логика поправки не зависит от рынка, но цифры его, а не наши.
Footnotes
-
White, H., «A Reality Check for Data Snooping», Econometrica 68(5), сентябрь 2000, с. 1097–1126 (полный текст прочитан: аннотация и введение; пример с рассылкой — во введении). ↩
-
Там же, раздел 4 «An Illustrative Example» и таблицы I и II (полный текст прочитан). Выборка: дневные доходности S&P 500 с 29 марта 1988 по 31 мая 1994; окно оценки с 3 июня 1991 по 31 мая 1994 (758 наблюдений); 29 индикаторов, все C(29,3) = 3654 модели с константой и тремя индикаторами. Параметры бутстрэпа N = 500, q = 0,5. «Технические» индикаторы выбраны, по словам Уайта, отчасти потому, что более ранние данные (Brock, Lakonishok, LeBaron, 1992) указывали на их возможную прогнозную силу в предыдущем периоде. ↩ ↩2 ↩3 ↩4
Частые вопросы
Что такое data snooping в трейдинге?
Использование одних и тех же данных и для выбора стратегии, и для её оценки. Уайт определяет его как ситуацию, когда набор данных используется более одного раза для вывода или выбора модели. Тогда хороший результат может быть случайностью, а не заслугой метода.
Что такое тест Reality Check?
Бутстрэп-тест Халберта Уайта (Econometrica, 2000) нулевой гипотезы о том, что лучшая модель, найденная при переборе, не превосходит бенчмарк по прогнозной силе. Он сравнивает лучший результат с распределением лучшего результата, который случайно получился бы среди всех опробованных моделей.
Сколько вариантов стратегии делают бэктест ненадёжным?
Фиксированного числа нет. В примере Уайта 3654 кандидата превратили p-значение 0,0036 в 0,2040. Чем больше вариантов и чем меньше они похожи, тем больше поправка. Сильно коррелированные варианты «стоят» меньше независимых.
Можно ли обойти data snooping проверкой на новых данных?
Свежие данные, которые не участвовали в выборе правил, — самый чистый ответ: один заранее объявленный тест на них не требует поправки на перебор. Reality Check нужен, когда есть только история.
Источники
- A Reality Check for Data Snooping. Halbert White. Econometrica 68(5), 1097–1126, сентябрь 2000, 2000
Статья — исследование, а не инвестиционная рекомендация. Результаты на истории не гарантируют результатов в будущем.